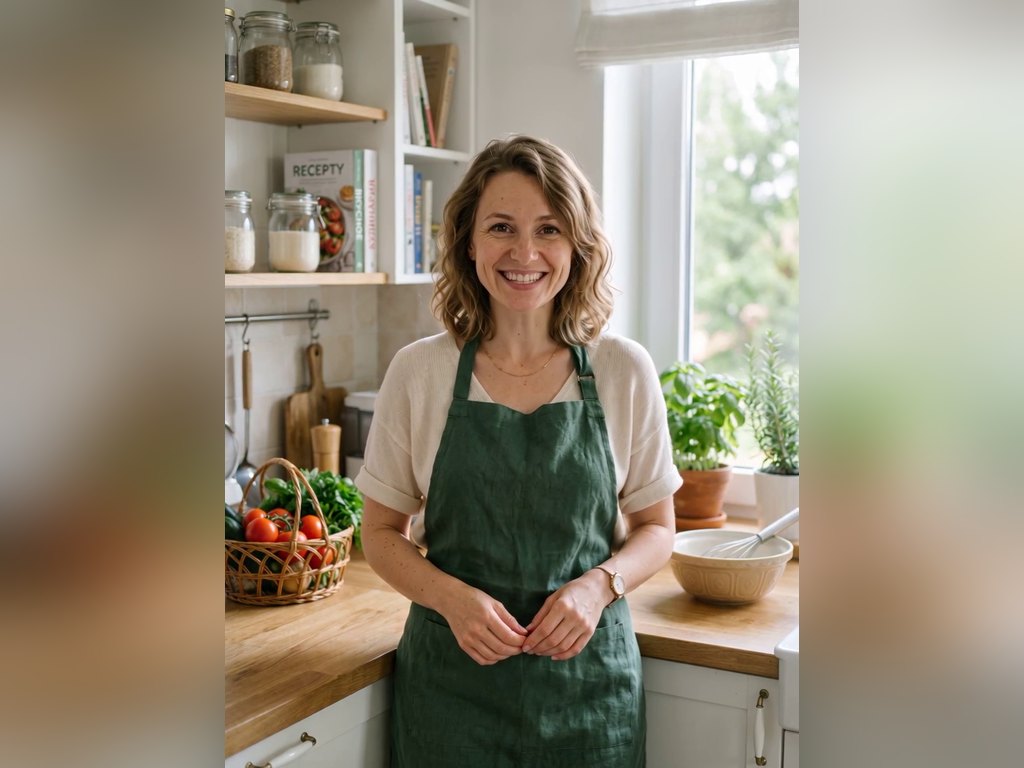
OmniHuman 2.0 от ByteDance делает говорящий аватар из двух файлов: фотографии человека и записи голоса. На выходе ролик, где человек произносит ваш текст или поёт, двигает губами в такт, моргает, жестикулирует. Писать описание сцены не нужно. Разберём, что подготовить, сколько длится ролик и во что обходится.
Что получается
Мы сделали портрет ведущей кулинарного блога на Nano Banana 2, записали фразу в озвучке ElevenLabs и отдали оба файла OmniHuman 2.0. Голос длился 6 секунд.
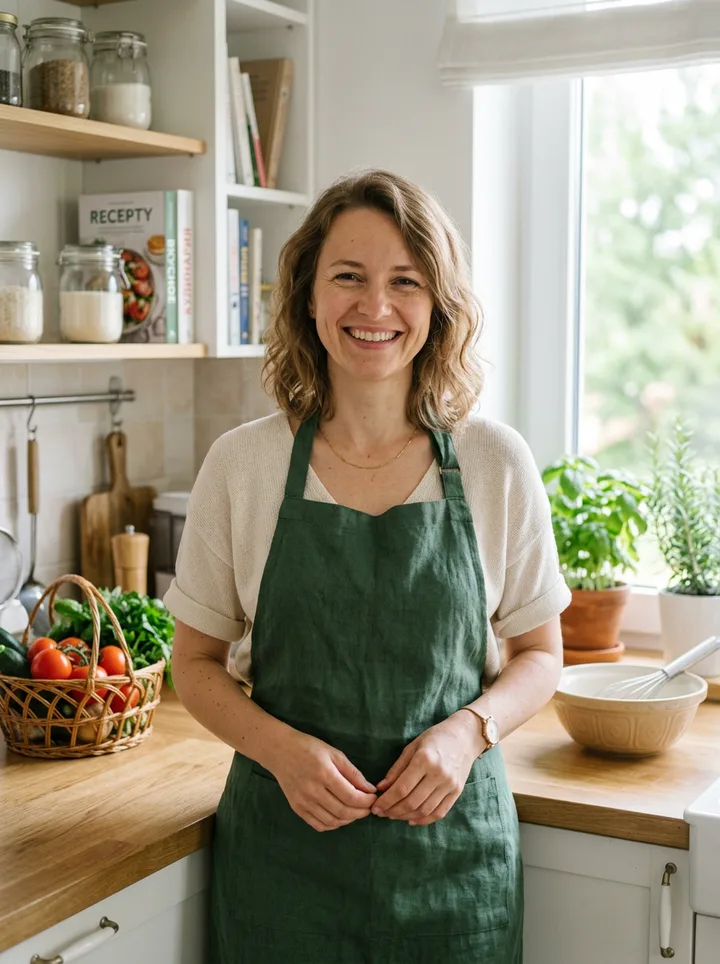
Привет! Сегодня покажу, как за десять минут приготовить сырники, которые не разваливаются на сковороде.
Губы двигаются под речь, руки включаются в жесты, лицо остаётся тем же человеком, что на фото, кухня на фоне не плывёт. Формат ролика повторяет формат фото: вертикальный портрет даёт вертикальное видео, удобно для Reels и Shorts.
Что нужно на вход
- Фото человека. JPG или PNG. Лицо должно быть хорошо видно: анфас или лёгкий поворот, без тёмных очков и рук у рта. Подойдёт и портрет по пояс, тогда в кадре будут видны жесты.
- Запись голоса. MP3 или WAV, от 4 секунд до 5 минут, не больше 15 МБ. Можно записать на телефон, взять готовый подкаст или сделать озвучку текста прямо в FTime AI, как в статье про озвучку текста голосом.
- Описание не нужно. Модель сама решает, как человек двигается под голос.
Голос лучше чистый, без музыки на фоне: модель ведёт губы по речи, и громкий фон сбивает её. Если запись шумная, сначала прогоните её через очистку звука Auphonic.
Для чего подходит
- Видео для блога и соцсетей без съёмки себя: ведущий читает новости, рецепт, обзор.
- Обучающие ролики и инструкции, где у текста должно быть лицо.
- Поздравления: персонаж с открытки или старое фото говорит или поёт. Если фото старое и мутное, сначала улучшите его, об этом статья как оживить старое фото.
- Песня от лица персонажа: модель умеет петь под готовый трек, если вокал в нём хорошо слышен.
Когда OmniHuman не подойдёт
Модель оживляет человека с фото, но не ставит сцену. Если нужно, чтобы персонаж шёл по улице, взял чашку или камера облетела его, берите обычную видеомодель с описанием, например Kling 4.0. Разрешение у OmniHuman одно, 720p, для большого экрана его мало. И помните о правах: оживлять чужое лицо без согласия человека нельзя.
Как сделать в FTime AI
- Откройте ai.ftime.org, вкладку «Видео», и выберите «OmniHuman 2.0 Аватар».
- В поле «Фото человека» загрузите портрет.
- В блок «Голос» добавьте запись MP3 или WAV.
- Поле описания оставьте пустым. Цена появится на кнопке сразу после загрузки голоса: она зависит от его длины.
- Готовый ролик появится в ленте, оттуда его можно скачать.
Сколько стоит
Платите за длину голоса. Секунда стоит около 20 кредитов, длина округляется до целых секунд вверх.
| Длина голоса | Цена |
|---|---|
| 5 секунд | 101 кредит |
| 15 секунд | около 303 кредита |
| 1 минута | около 1 212 кредитов |
Наш пример с голосом на 6,2 секунды посчитался как 7 секунд. Видео доступно на платных тарифах: на Pro хватит примерно на 25 роликов по 5 секунд или на пару минутных роликов. Тарифы на странице тарифов.
Параметры, цены и примеры модели собраны на странице OmniHuman 2.
Частые вопросы
Можно ли сделать ролик длиннее 5 минут?
Нет, предел голоса 5 минут. Длинную запись разрежьте на части и склейте ролики при монтаже: лицо в них будет тем же, раз фото одно.
Нужно ли писать описание сцены?
Нет. OmniHuman работает только от фото и голоса, поле описания для этой модели не используется.
Подойдёт ли нарисованный персонаж?
Модель рассчитана на человека в кадре. С рисованным персонажем результат зависит от рисунка: нужны понятные глаза и рот. Проверьте на коротком голосе в 4-5 секунд, прежде чем запускать длинный.
Можно ли попробовать бесплатно?
На 50 кредитах при регистрации видео не открыто. Начать можно с тарифа Лайт.